万卡集群 IB 计算网络架构设计:六步定拓扑
一句话:万卡网络不是"买一堆交换机和线"接起来,而是六个决策依次收敛——每 GPU 给几个口、要不要三层、收敛比给到多少、Rail 怎么对、POD 切多大、控制面放哪。这六个决策定完,拓扑图就基本唯一了。
本文讲的是设计方法,不是某一张图的拆解。图只出现一次:作为"六个决策全部落定之后的产物",用 1250 台 HGX H100 的真实形态收口。若你想逐层看那张图的端口怎么对账、报文怎么跳,另有一篇专讲。万卡级 IB 参数平面:三层胖树架构拆解
设计六步一览
| 步骤 | 决策 | 判据 | 本文实例取值 |
|---|---|---|---|
| 1 | 每 GPU 给几个 400G 口 | 训练 / 推理为主 | 1 GPU : 1 口 |
| 2 | 两层还是三层 | 端点数是高档口数的几倍 | 三层(313 台 Leaf > 64 口) |
| 3 | 收敛比 | 作业形态 + 预算 | 1:1 无收敛 |
| 4 | Rail 怎么对 | GPU 卡号与网卡、Leaf 的映射 | 8 轨,按 GPU index 对齐 |
| 5 | POD 切多大 | 故障域 / 布线域 / 并行策略 | 5 POD(4×256 + 1×226) |
| 6 | 控制面放哪 | SM / UFM 高可用 | UFM 双机 + SM 主备 |
一、先分清三个平面,别把存储和管理塞进计算面
万卡集群的网络从来不止一张网:
- 计算面(参数平面):GPU 与 GPU 之间,跑 NCCL All-Reduce、All-to-All,跑 MPI。这是 IB 的主场,也是本文对象。
- 存储面:并行文件系统(Lustre / GPFS)或对象存储,典型是另一套 IB 或 RoCE,独立的 Leaf/Spine。
- 管理面:带外 BMC、装机、监控,以及子网管理器(SM)与 UFM 的心跳。
三面必须物理或至少逻辑隔离(PKey / SL 或独立物理口)。原因是三件事不能共存:训练流量对时延极端敏感;存储流量是长时间大块突发;管理流量绝不能因为训练拥塞而断——SM 一旦连不上交换机,整张网就失去路由。这也是很多"小集群能跑、大集群老挂"的根因:不是设备不行,是把三类流量挤在同一张网上。
二、第一步:每 GPU 给几个 400G 口
这是整个设计里最贵、也最难回头的一个决定。
HGX H100 的板上是 8 张 GPU + 8 个 400G 集群口(4 张双口 ConnectX-7 mezzanine)。8 卡 8 口,天然就是 1 GPU : 1 口,每节点对外 8×400G = 3.2 Tb/s。一旦按 2 GPU 共享 1 口去设计,注入带宽直接腰斩,All-Reduce 的理论上限也跟着腰斩——而且这种"省一半口"的节省,通常只省下 Leaf 层的端口和一小部分光模块,换来的是每一轮迭代都慢一倍。
判据很直接:
- 预训练 / 大规模微调为主 → 1 GPU : 1 口,不做任何口收敛;
- 推理为主 → 2 GPU : 1 口甚至更低可接受,因为推理的通信是请求级稀疏流量,不是同步屏障;
- 混合负载 → 按作业队列比例定,宁可给训练留足,再在调度层把推理作业限制在低带宽分区。
按本例:1250 台 × 8 口 = 10000 个 400G 端点,聚合注入能力 10000 × 400 Gb/s ≈ 4 Pb/s。这个数字是后面所有层级配比的基准——先把它钉死,再谈交换机。
三、第二步:用高档口数算层数,别凭感觉
层数不是拍脑袋定的,是除出来的。对一台 k 口交换机,要做到 1:1 无收敛,每台交换机只能把一半端口朝下接端点、一半朝上接上一层:
每台 Leaf 可接端点 = k / 2
Leaf 总数         = N / (k / 2)
若 Leaf 总数 > k  → 必须三层(加 Core / Super-Spine)
代入 64 口 NDR 交换机(k = 64):
- 每台 Leaf 最多接 32 个端点(另 32 口上行);
- 10000 个端点 → 10000 / 32 = 312.5 → 取整 320 台 Leaf;
- 320 > 64 → 必须三层。
由此得到一个特别有用的临界点:64 口交换机在 1:1 下,两层最多撑 64 × 32 = 2048 个 GPU。这就是"2048 卡是两层天花板"的算术来源,也是万卡集群几乎必然是三层胖树的根本原因,与厂商偏好无关。
顺带看一代硬件的走向:800G 时代的 Quantum-X800 Q3400 是 144 口,144 × 72 = 10368 端点——一万卡刚好能塞回两层。层数省一层,就省一整层交换机和一层光模块,这也是下一代集群设计的最大红利点。
提示:Leaf 取整要按"组"取,不要按台取。本例按 8 台一组,320 = 40 组 × 8 台,组数与 POD 划分、Rail 编号都要能对上,否则后面布线表会乱。
四、第三步:定收敛比,并把"端口对账"升级成"带宽对账"
收敛比(oversubscription)的定义是一句话:
收敛比 = 下行总端口数 / 上行总端口数等于 1 就是无收敛,任何两个端点之间都能跑满线速;2:1 意味着两路下行抢一路上行,全网同时打满时每路只剩一半。
| 收敛比 | All-to-All 峰值带宽 | 交换机数量 | 适用 |
|---|---|---|---|
| 1:1 | 100% | 最多 | 预训练、大规模并行、All-to-All 密集(MoE) |
| 2:1 | ~50% | 少约 1/3 | 微调、混合负载 |
| 3:1 ~ 4:1 | 25% ~ 33% | 少一半以上 | 推理、单机为主的小作业 |
设计时最常犯的错是只对端口数对账、不对带宽对账:Leaf 下行 10240 口、上行 10240 口,看起来 1:1 很漂亮;但如果上行一半口接的是同一个 Spine 组,实际等价路径不足,高峰期照样排队。所以对账要落到三件事:
- 每一层级 下行口数 = 上行口数(数量);
- 每一层级的上行口均匀散布到上层所有组(分布);
- 任取两个端点,最坏路径的带宽 = 单口线速(路径)。
本例每层都是 10240 口 1:1,且 Leaf 上联按"组对组全互联"散布,所以前两条都成立;第三条要在验收阶段用跨 POD 的 All-Reduce 实测确认,见第十节。
五、第四步:Rail 对齐,把"8 卡 8 口"变成"8 条轨"
这是万卡设计里最容易被省略、又最影响实测成绩的一步。
不按 Rail 排的接法是"每台机器的 8 个口随便接到就近的 Leaf"。按 Rail 排的接法是:全集群所有节点的 GPU0 都接到 Rail 0 的 Leaf,GPU1 接 Rail 1……GPU7 接 Rail 7,每一条轨对应一层 Leaf 组。
好处是通信路径变短:NCCL 的 Ring 与 Tree 算法在 rail 内先做局部聚合,同一条 rail 上的流量只跨一层 Leaf-Spine;跨 rail 才上更高层。对 8 卡节点的 All-Reduce,这意味着大量流量在网络里只走两跳。
代价也要认:
- 故障域被放大:某条 rail 的 Leaf 或光模块出问题,全集群所有节点的同一卡位(比如全部 GPU3)同时受影响,看起来像"训练框架挂了",其实是网络单轨退化;
- 布线纪律要求高:每柜 8 束、每束一种颜色或标签,插错一根就是"某台机器的某个 GPU 走错轨",性能只在特定通信模式下才暴露,极难查。
配套做法:Rail 表(节点 → 8 个口 → 8 个 rail → 对应 Leaf 端口)必须作为交付物留存,验收和故障定位都靠它。384 卡规模上这套做法怎么落地,见 Rail 拓扑 + 1.5:1 收敛设计。
六、第五步:切 POD,让"大多数流量不出门"
POD 不是机柜分组的别名,它同时是故障域、布线域、调度域。切得好的标志是:日常训练的大部分集合通信在 POD 内部闭环,只有跨 POD 的数据并行梯度同步才上 Core。
切割依据按优先级排:
- 交换机组的整数倍:一个 POD 的 Leaf 数应是"组 × 8 台"的整数倍,这样组对组全互联才整齐;
- 机柜与电力的边界:POD 边界最好与列头柜、供电分区重合,故障隔离才真实;
- 并行策略:把同一数据并行组尽量放进同一 POD,让 All-Reduce 留在 POD 内。
本例 1250 台切成 5 个 POD:前 4 个各 256 台(2048 口 / 64 台 Leaf / 8 组),第 5 个 226 台(余数,Leaf 不插满)。这样每个满配 POD 的 Leaf 下行 64×32 = 2048 口,与 256 台服务器的 2048 个口一一对应,一台不多一台不少。
七、第六步:控制面决定这张网能不能被运维
硬件铺完,网络的"大脑"是子网管理器。
- SM 主备:全网必须恰有一个主 SM 计算 LID 与路由,另一个待命。万卡规模下 SM 切换要演练,不能只写在文档里。
- UFM 双机:本例图中右侧两台 UF M 服务器就是控制面,负责拓扑发现、端口健康、误码统计与故障定位。一台宕机另一台接管。
- SHARP:Quantum-2 支持 SHARPv3,All-Reduce 的归约可以在交换机里做,通信量能砍一刀。但它是"要显式开启"的能力,默认不开,很多集群买了支持 SHARP 的交换机却从没用过。
- PKey / SL:计算面、存储面用不同 PKey 隔离;计算流量映射到高优先级 VL,拥塞时先保训练。
- 自适应路由:优先开,配合 credit 流控在 80% 以上负载时保住尾时延。
LID 容量顺手核一下:IB 的 LID 是 16 位,OpenSM 常规可用区约 4.9 万个,一万端点加近千台交换机完全够用;真正要担心的是路由表规模和 SM 收敛时间,不是 LID 数量。
八、实例:1250 台 HGX H100 的三层胖树
六个决策全部落定之后,形态是这样的:三层胖树,320 台 Leaf(40 组 × 8 台)、320 台 Spine(40 组 × 8 台)、256 台 Core(8 组 × 32 台),1250 台 8 卡服务器,两台 UFM 做控制面。
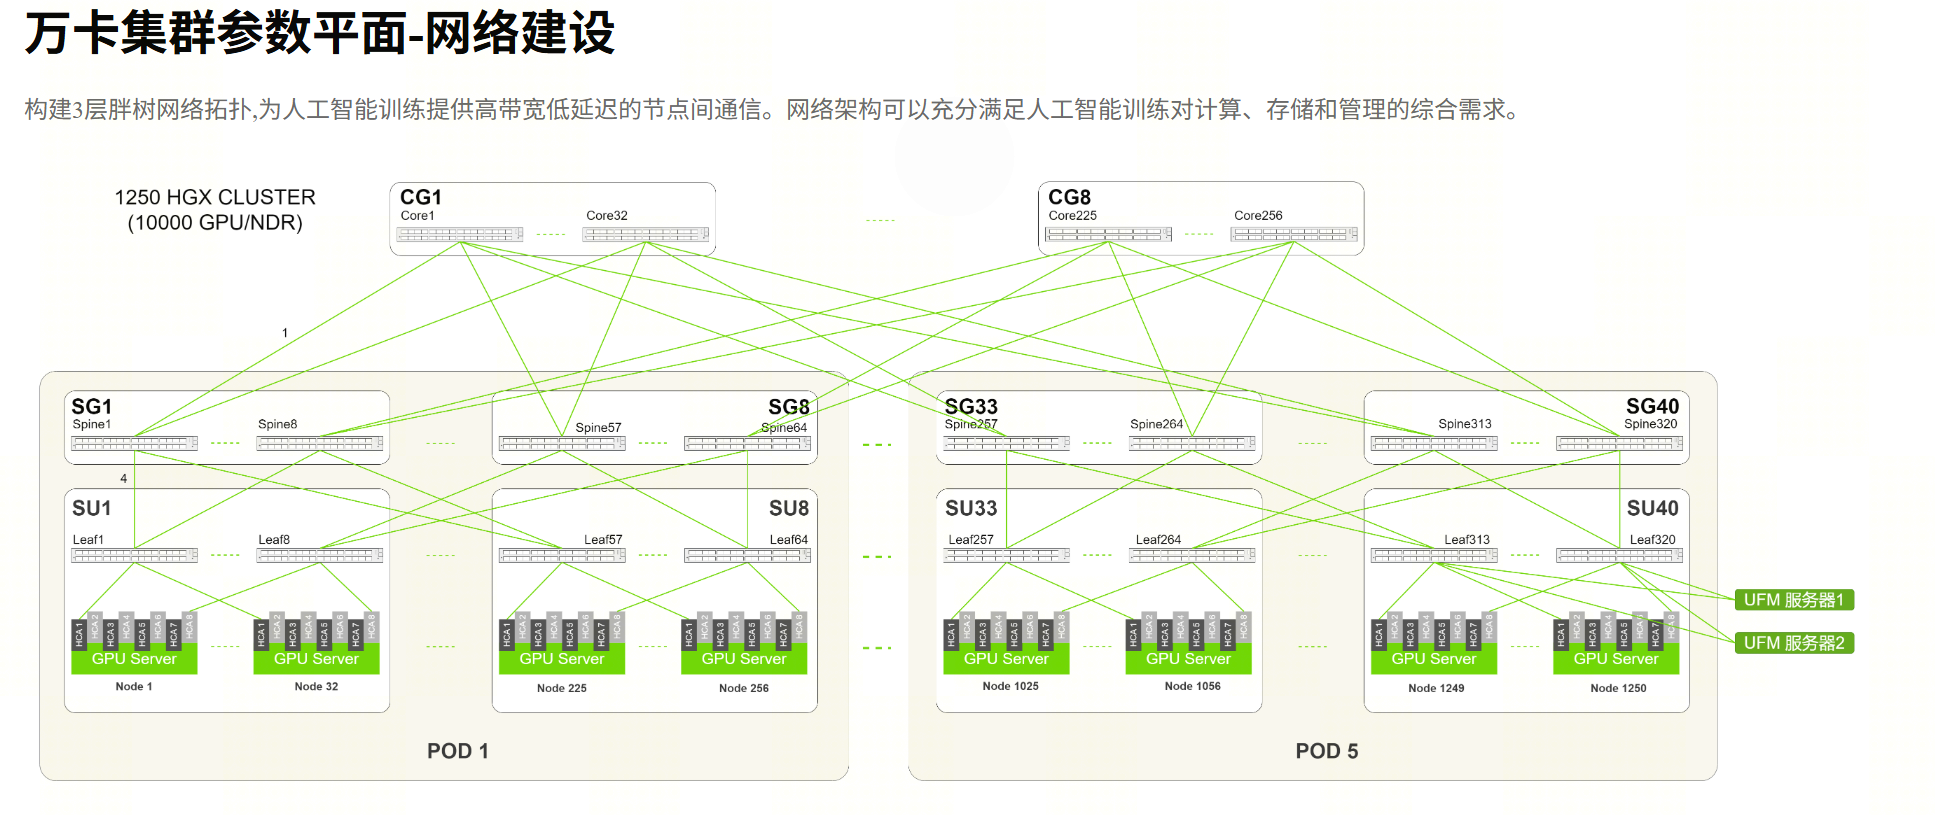
端口对账(按图面反推):
| 层级 | 数量 | 每台端口 | 下联 / 上联 | 对账结论 |
|---|---|---|---|---|
| 端点 | 1250 台 × 8 口 | 400G | 10000 口注入 | 1 GPU : 1 口 |
| Leaf | 320 台(40 组 × 8) | 64 | 32 下 + 32 上 | 下 10240 ≥ 10000,留 2.4% 余量 |
| Spine | 320 台(40 组 × 8) | 64 | 32 下 + 32 上 | 10240 ↔ 10240,1:1 |
| Core | 256 台(8 组 × 32) | 64 | 40 接 Spine + 24 组间 | 40 × 256 = 10240,1:1 |
一个必须提前确认的取舍:Core 每台 64 口,40 口接 Spine,剩下约 24 口用于 Core 组间互联。按图面反推,组间总端口约 256 × 24 = 6144,相对 10240 的注入量约 0.6:1。也就是说,POD 内与邻近 POD 是严格无收敛的,但全部 5 个 POD 同时打满的 All-to-All,顶层并非严格 1:1。
这不是缺陷,是取舍:Core 组间做满 1:1 需要再加一层或换更高档口数的交换机,成本陡增。正确做法是把它显式化——
- 把 0.6:1 写进设计文档的"收敛比预算",别在验收时才被发现;
- 调度层优先让作业在 POD 内成组(数据并行组不跨 POD,或只跨少数 POD);
- 验收时专门做一次"5 POD 全覆盖"的 All-to-All,拿实测值和理论值对,心里有数。
如果你的场景是 MoE 这类 All-to-All 极重的训练,顶层这一步就得重新算:宁可少 10% 的 GPU,也别让顶层成为全网瓶颈。
九、五个最容易踩的设计错误
- 用端口数对账代替带宽对账:数字漂亮,路径不通。必须核到"最坏路径带宽"。
- 只部署一台 SM:SM 是单点,宕了整网失路由。主备 + 切换演练是硬要求。
- Rail 没对齐也没留 Rail 表:性能只在特定通信模式暴露,排障时无从下手。
- 光模块预算漏算:万卡约一万个 400G 端口,交换机 BOM 之外的光模块/线缆常常是更大一笔;业内 1024 卡 NDR 集群的光模块预算常在百万美元量级,按端口数 × 单价先立预算,再谈选型。
- 把存储面和管理面挤进计算面:短期省设备,长期是整网稳定性事故的源头。
十、交付前的验收清单
- 物理层:
ibstat全绿、端口速率与宽度符合设计、误码基线存档; - 单跳:
ib_write_bw/ib_read_lat在同 Leaf、同 Spine、跨 Core 三种距离各测一遍; - 拓扑一致性:Rail 表与实际线序抽查 10%,插错一根都要找出来;
- 集合通信:NCCL All-Reduce 从单 POD 到 5 POD 全覆盖,看带宽衰减曲线是否与收敛比预算吻合;
- SHARP 生效:开启前后的 All-Reduce 时长对比,不开等于白买;
- 控制面:SM 主备切换演练、UFM 双机接管,记录切换时长与业务影响。
收口三句
- 入口定死 1:1:每 GPU 一个 400G 口,这一层省不得。
- 层数按算术定:Leaf 数超过高档口数就必须三层;换高 radix 能把万卡塞回两层。
- 收敛比按作业定:训练网无收敛,推理网可收敛,混合负载按队列比例取舍,并且把取舍写进文档。
设计做完,剩下的都是施工与运维。而施工的第一份文件,永远是那张端口对账表。